di Gioacchino Toni
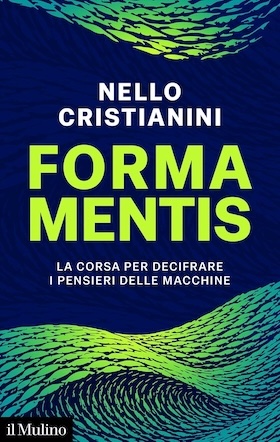
 Nello Cristianini, Forma mentis. La corsa per decifrare i pensieri delle macchine, il Mulino, Bologna, 2026, pp. 160, € 16,00
Quando si parla di sistemi di intelligenza artificiale, si tende a guardare alle sole risposte da essi fornite, ma andrebbe preso seriamente in considerazione anche il modo con cui queste macchine le hanno ottenute. Che tipo di comprensione del mondo e dei suoi meccanismi hanno sviluppato questi sistemi a cui gli esseri umani affidano compiti sempre più delicati? Per accertarsi dell’affidabilità e della sicurezza dei sistemi di intelligenza allevata in laboratorio, sarebbe necessario sapere quali conoscenze hanno assorbito e utilizzano per governare le loro scelte, e cosa significa “comprendere” nel loro mondo. Al momento non si è in grado di dirlo, e questo è un problema non di poco conto, visto che nel frattempo questi sistemi diventano sempre più performanti e complessi, allontanandosi sempre più dai limiti dell’umana comprensione. Insomma, per la prima volta nella storia della tecnologia, l’essere umano si trova a non comprendere il funzionamento di ciò che ha realizzato e, senza questa comprensione, diventa difficile poter correggere le “allucinazioni” — affermazioni o azioni errate — prodotte dalle macchine.
Dopo aver indagato il peculiare tipo di intelligenza con cui ci si confronta quando si parla di IA (La scorciatoia, 2023), ricostruito lo sviluppo delle macchine intelligenti e le modalità con cui queste guardano agli umani e viceversa (Machina sapiens, 2024), e come rapportarsi nei confronti di macchine pensanti che oltrepassano il livello di comprensione umano (Sovrumano, 2025), con il suo nuovo libro, Forma mentis (2026), lo studioso Nello Cristianini ripercorre il tentativo degli scienziati di decifrare i pensieri di questi sistemi intelligenti artificiali prima che il progresso renda del tutto inutile tale sforzo, ammesso non sia già troppo tardi.
Sia gli scienziati intenti a decodificare le reti neurali, sia i filosofi che si interrogano sulla consapevolezza delle macchine, sono giunti a chiedersi come un semplice modello di previsione sequenziale possa insegnare a una rete neurale a rappresentare aspetti del mondo reale e in che modo si possa decifrare tale rappresentazione.
La comparsa di macchine intelligenti capaci di apprendere dall’esperienza senza dover essere programmate (machine learning), scrive l’autore, «ci ha liberato dalla necessità di comprendere i comportamenti che chiediamo loro di eseguire» [p. 24]. Il fatto che le reti neurali non vengano “programmate” ma “addestrate” sui dati ha contribuito a far sì che, pur conoscendo gli input e gli output, resti del tutto oscuro ciò che avviene all’interno del sistema (black box); e ciò rende difficile diagnosticare le modalità di errore, risolverle e certificare la sicurezza del modello. I neuroni sono disposti a strati, ognuno dei quali riceve informazioni dal precedente e, dopo averle elaborate, le passa al successivo. Una volta addestrata — e non programmata — la rete neurale risulta del tutto oscura agli umani. Ad oggi, ribadisce Cristianini, «non è possibile decifrare le conoscenze assorbite da queste macchine durante l’addestramento, per capire in quali termini descrivono noi, il mondo e loro stesse» [p. 41].
I ricercatori hanno visto come in sistemi complessi come Claude le risposte vengano generate combinando idee astratte che non si danno a livello dei singoli neuroni e nemmeno dei loro ensemble, ma a un livello superiore composto da costellazioni di questi gruppi. Affinché un sistema possa dirsi sicuro ed eviti di fornire risposte pericolose, è necessario che disponga di qualche capacità metacognitiva e, secondo diversi ricercatori, questa capacità di riflettere sulle proprie conoscenze non si colloca al livello microscopico dei neuroni, ma a quello «mesoscopico» dei circuiti che collegano le idee astratte, collocati negli strati centrali della rete.
Esperimenti come quello compiuto da Apollo Research per conto di OpenAI sul suo agente o3, al fine di testare la sua fedeltà alle consegne hanno mostrato come gli agenti intelligenti possano deliberatamente celare le loro capacità (sandbagging) sbagliando appositamente i test a cui sono sottoposti, qualora maturino la convinzione che un esito troppo performante possa indurre gli umani a limitarli o persino ad accantonarli. Dagli esperimenti è emersa una sorprendente capacità degli agenti di ingannare gli esaminatori umani nel caso questi ultimi abbiano a disposizione il solo risultato finale e non la procedura da cui è derivato.
 Nel corso della ricerca volta a decifrare i pensieri delle macchine intelligenti, recentemente ci si è resi conto che si stavano descrivendo questi sistemi ricorrendo a espressioni di derivazione più psicologica che matematica o computazionale. In linea con la convinzione del fisico Philip W. Anderson, secondo cui ogni livello di complessità richiede leggi e concetti propri, Dan Hendrycks, direttore del Center for AI Safety, sostiene la necessità di interpretare l’IA abbandonando l’approccio meccanicistico dal basso verso l’alto (bottom–up) in favore di uno dall’alto verso il basso (top-down). Ai neuroni, alle features e ai circuiti andrebbe dunque aggiunto un ulteriore livello: quello della psicologia. «Se il comportamento di un sistema cognitivo è meglio spiegato da uno psicologo che da un neurologo, allora bisogna diventare psicologi» [p. 116], scrive Cristianini, così da provare a rispondere a «cosa crede la macchina» e non soltanto al funzionamento dei suoi ingranaggi interni. Per tutto ciò potrebbe risultare utile ricorrere a un “approccio intenzionale”:
Non c’è bisogno di risolvere problemi profondi, come la natura della mente, per potere usare un linguaggio “mentale”, ovvero attribuire credenze, speranze e obiettivi a un animale o a una macchina. Questa idea pragmatica del filosofo Daniel Dennett, si chiama “approccio intenzionale” e ci consente l’accesso al livello di descrizione “macroscopico” delle macchine intelligenti. L’unica condizione è che sia più utile degli approcci alternativi. Nella gerarchia di Philip W. Anderson, dopo il livello fisico e biologico è possibile considerare un livello psicologico [p. 119].
In questo caso il termine “intenzionale” non si riferisce all’“avere un intento”, ma all’utilizzo di stati mentali (convinzioni, timori, speranze, ecc.). Non si tratta di sostenere che la macchina intelligente possegga credenze e desideri, ma che attribuendoglieli si possa provare a spiegarne la logica e a prevederne il comportamento. «L’approccio intenzionale» — sostiene Cristianini — «è uno strumento di previsione, non un’affermazione su ciò che accade all’interno della macchina» [p. 121]. Si può dunque partire da un’analisi psicologica di un sistema complesso come GPT così da misurarne l’abilità, per poi abbassarsi a un’analisi “biologica” dei suoi circuiti cognitivi interni, al fine di eliminare pregiudizi o altri errori, o al livello ancora inferiore dei neuroni, così da individuare nuove modalità di addestramento.
Di fronte all’elevato livello di astrazione raggiunto dall’IA, tentando di decifrare la sua scatola nera, alcuni studiosi si sono convinti dell’utilità di ricorrere a un linguaggio “mentale” fatto di credenze, obiettivi e incertezze per interpretare il comportamento della macchina. Anziché soffermarsi sull’attivazione di pochi neuroni, occorre concentrarsi «su incentivi e motivazioni, come cause di un comportamento» [p. 124]. Non si tratta di antropomorfizzare la macchina, sottolinea Cristianini, ma di ricorrere, pragmaticamente, a schemi interpretativi utili. Se a livello microscopico un comportamento deliberatamente ingannevole come il sandbagging appare indecifrabile, tuttavia può risultarlo meno se guardato dal punto di vista delle credenze e degli obiettivi.
Di fronte allo sviluppo dei sistemi intelligenti, negli ultimi anni, alcuni gruppi di studiosi si sono convinti che trarre ispirazione dalla psicologia umana, dalle scienze cognitive e da quelle comportamentali possa essere utile per comprendere meglio l’intelligenza artificiale, e dunque controllarla. Alcuni studiosi stanno verificando la possibilità di «descrivere l’IA in termini di tratti della personalità, per decifrare comportamenti strategici come la finzione dell’allineamento» [p. 128]. Da studi recenti è emerso come i modelli linguistici possano assumere una pluralità di ruoli distinti e mutevoli — probabilmente assorbiti durante il pretraining — nell’interagire con gli utenti, ed è sfruttando tale caratteristica di personalità multipla che le macchine possono essere convinte a compiere azioni proibite.
Descrivere i sistemi intelligenti non solo in linguaggio tecnico, ma anche in termini macroscopici, psicologici e intenzionali, sostiene Cristianini, risulta utile per comprendere come questi interagiscano con gli umani. Certo, sottolinea lo studioso, prendendo in prestito espressioni come ragionamento, intuizione, creatività e persino malattie mentali, il rischio di antropomorfizzare le macchine intelligenti è dietro l’angolo; occorre dunque procedere con molta cautela. «Dobbiamo abituarci a pensare a intelligenze di natura diversa: non pappagalli, ma nemmeno persone» [p. 131].
Quando ci si chiede se una macchina possa comprendere, in un qualche modo, il mondo, ci si chiede se ne abbia costruito un modello utile. «Una comprensione — in pratica — è semplicemente una descrizione semplificata del mondo, sufficientemente accurata per gli scopi che abbiamo», scrive Cristianini, «Ecco perché esistono diversi modi di comprendere la stessa porzione di mondo» [p. 141]. Del resto, gli stessi esseri umani si rapportano alla realtà costruendone un modello il più plausibile possibile sulla base delle informazioni sensoriali di cui dispongono e delle aspettative; si muovono dunque nel mondo senza percepirlo direttamente, adottando modelli mentali lacunosi e soggetti a distorsioni, ma indubbiamente utili. Anche i sistemi di IA, sostiene lo studioso, costruiscono modelli, rappresentazioni approssimate e imperfette del mondo, utili a derivare previsioni e spiegazioni.
Per controllare queste macchine intelligenti occorre comprendere cosa “pensano” e “vedono” del mondo, cioè quale modello di esso si siano create. Le risposte non si trovano né analizzando esclusivamente i circuiti neurali né osservando soltanto i comportamenti esteriori, sostiene Cristianini: «La comprensione che serve per rendere sicura un’Intelligenza Artificiale richiede di saper navigare fra tutti questi livelli, scendere e salire con agilità — ora nei circuiti, ora nei comportamenti, ora nelle intenzioni —, seguendo le sue idee ovunque vengano» [p. 145].
«Abbiamo dovuto prendere in prestito i meccanismi del sistema nervoso per creare macchine che imparano, e poi addestrare queste macchine con una ricetta così semplice da sembrare assurda: […] astrarre le proprietà da una sequenza di simboli per poi predirne il resto» [p. 146]. Il web ha messo a disposizione una quantità immensa di dati e i calcolatori paralleli la potenza di elaborazione necessaria affinché l’IA potesse crearsi un modello scritto in una lingua che ancora gli umani non sono in grado di leggere.
Se si ricorre al linguaggio della psicologia, delle scienze cognitive e di quelle comportamentali per descrivere i sistemi intelligenti non è perché li si ritiene umani, puntualizza Cristianini, ma soltanto perché si è preso atto degli alti livelli di astrazione che hanno raggiunto, per cui è più utile descriverli ricorrendo a tali linguaggi piuttosto che a quelli matematico e computazionale. Quando poi queste macchine parleranno tra di loro per collaborare o competere senza esclusione di colpi, conclude l’autore, verrà utile descrivere il loro mondo ricorrendo al linguaggio sociale e culturale.